Handboek · hoofdstuk 39Data visualiseren en eerste stappen in AI
Van logboek naar grafiek naar een model dat zelf zijn regels leert, en wat het niet kan
Een logboek met tienduizend regels zegt niets tot je het goed toont. In dit hoofdstuk kies je de grafiek die bij je vraag past, herken je grafieken die misleiden, en leer je waarom twee grootheden samen kunnen bewegen zonder dat de ene de andere veroorzaakt. Daarna zet je een eerste stap in kunstmatige intelligentie: je laat de computer uit voorbeelden een beslisboom leren die voorspelt wanneer de sla in de klimaatmodule water tekortkomt, je toetst hem eerlijk, en je zoekt uit wat zo'n model niet kan.
- Je kan bij een vraag de passende grafiek kiezen en een grafiek maken met correcte assen, eenheden en bron.
- Je kan misleidende grafieken herkennen, de liegfactor berekenen en een grafiek eerlijk maken.
- Je kan uitleggen waarom correlatie geen oorzakelijk verband bewijst, en een gemeenschappelijke oorzaak opsporen door in groepen te kijken.
- Je kan uitleggen wat machine learning is en niet is, en de begrippen kenmerk, label, model, trainen en testen gebruiken.
- Je kan met de hand de beste splitsing van een beslisboom zoeken en een boom volgen om een voorspelling te maken.
- Je kan een beslisboom trainen en toetsen in Python, een verwarringsmatrix lezen en overfitting herkennen.
- Je kan bias in data herkennen en de grenzen van een model benoemen voor je het laat beslissen.
Een kaart die een pomp liet sluiten
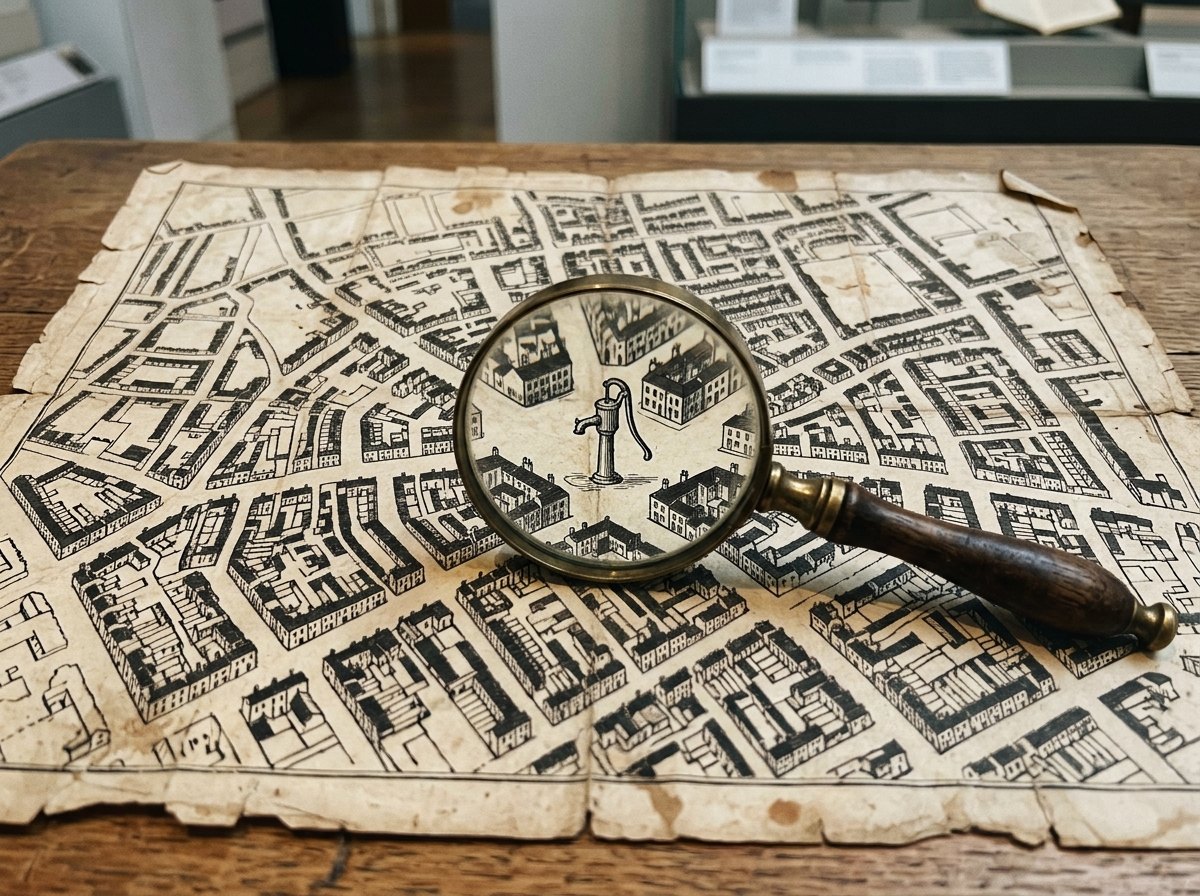
Eind augustus 1854 brak in de Londense wijk Soho cholera uit. Binnen enkele dagen stierven honderden mensen. De meeste artsen dachten dat de ziekte zich verspreidde via 'slechte lucht'. De arts John Snow vermoedde dat het water de boosdoener was. Hij ging van deur tot deur, noteerde waar de doden woonden, en zette ze op een kaart van de straten: een streepje per dode, bij het huis.
Op de kaart zag iedereen wat in een tabel verborgen bleef: de doden lagen dicht rond één waterpomp, in Broad Street. Snow keek ook naar de uitzonderingen. Een brouwerij vlak bij de pomp had bijna geen zieken: de arbeiders dronken bier en hadden een eigen put. Een vrouw die ver weg woonde maar wel stierf, liet water van Broad Street halen omdat ze het lekkerder vond. Op 8 september 1854 liet het bestuur van de parochie de hendel van de pomp verwijderen. De uitbraak nam toen al af, maar Snows kaart werd een van de bekendste grafieken ooit, omdat ze een oorzaak zichtbaar maakte.
Snow toonde de juiste data op de juiste manier, en keek kritisch naar wat niet paste. Dat doe je in dit hoofdstuk met het logboek van de klimaatmodule: grafieken kiezen, misleiding herkennen, en een verband pas een oorzaak noemen als je de alternatieven hebt uitgesloten. Daarna leer je de computer zelf een regel vinden, en zie je waarom ook die kritisch getoetst moet worden.
Wat je al weet, en de juiste grafiek kiezen
Je kan al veel met data:
| wat je al kan | waar | wat er nu bij komt |
|---|---|---|
| een tabel en een grafiek maken, assen met grootheid en eenheid | F4 | kiezen welke grafiek bij welke vraag past |
| een trendlijn en de correlatie tussen twee grootheden | I3, I28 | wanneer een verband geen oorzaak is |
| CSV inlezen, per dag samenvatten, matplotlib | I28 | eerlijke en misleidende grafieken |
| de datalogger, opschonen, logboek.py | I30 | de testweek per uur, als basis voor analyse |
| algoritmen, en systemen die leren uit voorbeelden (eerste kennismaking) | F22 | een model dat zelf zijn regels leert: de beslisboom |
| if, elif, else en toestanden | I27, I32 | een getrainde boom is een rij if-vragen |
Een grafiek beantwoordt een vraag. Kies eerst de vraag, dan de grafiek:
| vraag | grafiek | voorbeeld uit de module |
|---|---|---|
| hoe verandert iets in de tijd? | lijngrafiek | temperatuur per uur |
| hoe verhouden aparte groepen zich? | staafdiagram | verbruik en zon per dag |
| hangen twee grootheden samen? | spreidingsdiagram | verbruik tegenover daglicht |
| hoe zijn metingen verdeeld? | histogram | hoe vaak elke temperatuur voorkwam |
| welk deel van een geheel? | taartdiagram (weinig delen) of gestapelde staaf | het energiebudget: 93 % lampen |
Een lijngrafiek verbindt metingen die in de tijd op elkaar volgen: de lijn suggereert dat er tussen twee metingen ook iets was. Voor losse groepen (dagen, materialen, bewoners) gebruik je staven, die altijd bij 0 beginnen omdat hun lengte de waarde is. Een spreidingsdiagram zet twee grootheden tegen elkaar, zonder lijn. Een histogram telt hoe vaak waarden in een klasse vallen. Een taartdiagram toont delen van een geheel, maar alleen goed met weinig delen: hoeken vergelijken is moeilijker dan lengtes.
Een grootheid en een eenheid op elke as, een legende als er meer dan één reeks is, een onderschrift dat zegt wat je moet zien, de bron van de data, en de periode.
Van minuten naar uren: uurwaarden.py
Het logboek van de klimaatmodule schrijft elke minuut een regel (hoofdstuk 30): 10 079 regels voor de testweek. Voor de grafieken en de analyses van dit hoofdstuk vat je ze samen per uur. Het programma gebruikt logboek.py uit hoofdstuk 30 om de dagbestanden in te lezen en de onmogelijke waarden weg te halen, verzamelt de minuten per uur in een woordenboek (hoofdstuk 28), en schrijft per uur een gemiddelde (temperatuur, vocht, licht, spanning) of een som (energie).
# uurwaarden.py - de testweek van de logger (hoofdstuk 30) per uur samenvatten in één CSV-bestandimport csvfrom logboek import lees_week, opschonen # logboek.py uit hoofdstuk 30 rijen = lees_week()print("opgeschoond:", opschonen(rijen), "regels met onmogelijke waarden")uren = {} # "2026-10-12 09:00" -> de minuten van dat uurfor r in rijen: uren.setdefault(r["tijd"].strftime("%Y-%m-%d %H:00"), []).append(r) def gemiddelde(waarden): geldig = [w for w in waarden if w is not None] return sum(geldig) / len(geldig) with open("week_uur.csv", "w", newline="") as f: schrijver = csv.writer(f) schrijver.writerow(["uur", "temperatuur_C", "vocht_pct", "verbruik_Wh", "zon_Wh", "licht_lx", "batterij_V"]) for uur, rs in sorted(uren.items()): schrijver.writerow([uur, round(gemiddelde([r["T"] for r in rs]), 2), round(gemiddelde([r["RV"] for r in rs]), 1), round(sum(r["verbruik"] for r in rs), 1), round(sum(r["zon"] for r in rs), 1), round(gemiddelde([r["licht"] for r in rs])), round(gemiddelde([r["bat"] for r in rs]), 2)])print(len(uren), "uren in week_uur.csv")Uitvoer, en het begin van week_uur.csv:
opgeschoond: 3 regels met onmogelijke waarden
168 uren in week_uur.csv
uur,temperatuur_C,vocht_pct,verbruik_Wh,zon_Wh,licht_lx,batterij_V
2026-10-12 00:00,17.92,84.1,7.4,0.0,0,13.25
2026-10-12 01:00,17.99,84.1,7.4,0.0,0,13.25
2026-10-12 02:00,18.09,83.9,7.4,0.0,0,13.25
…
Een gemiddelde over de geldige minuten laat de lege cellen weg; een som van energie telt elke minuut. Dinsdag om 14 uur heeft 59 minuten (de regel die ontbrak), woensdag om 11 uur 48 geldige temperaturen. Dat is goed genoeg voor een uurgemiddelde, maar vermeld het.
Vier vragen, vier grafieken
Een bewoner stelt vier vragen over de testweek. Welke grafiek beantwoordt elke vraag het best, en wat is het antwoord? (a) Was het in de module ooit te warm? (b) Welke dag had een tekort aan zonnestroom? (c) Verbruikt de module minder als er meer daglicht is? (d) Welke temperatuur kwam het vaakst voor?
- week_uur.csv (168 uren)
- de keuzetabel van het vorige blad
- een grafiektype en een antwoord per vraag
- 1(a) Te warm? Een verloop in de tijd: de lijngrafiek van de temperatuur (blad 2). Het warmste uur was 24,4 °C: ver onder de 27 °C waarbij het dak opengaat (hoofdstuk 31).
- 2(b) Tekort? Aparte dagen vergelijken: staven, verbruik en zon naast elkaar. Woensdag: 2,15 kWh verbruik, 1,27 kWh zon; zondag 2,02 tegenover 1,89 kWh.
- 3(c) Samenhang? Twee grootheden tegen elkaar: een spreidingsdiagram van het verbruik per uur tegenover het daglicht (figuur). Meer licht, minder verbruik: de lampen dimmen mee (hoofdstuk 25).
- 4(d) Verdeling? Een histogram van de 168 uurtemperaturen (figuur). 119 van de 168 uren lagen tussen 17 en 20 °C: de nachten en de avonden, waarin het station de module op ±18 °C houdt; de klasse van 19 tot 20 °C komt het vaakst voor.
Misleidende grafieken: de as en de twee assen
Een grafiek kan correct zijn, met juiste getallen, en toch iets verkeerds laten zien. Twee klassieke trucs:
De afgeknotte as. Bij staven is de lengte de boodschap. Begint de as bij 1,2 in plaats van 0, dan is de staaf van donderdag (2,43 kWh) 17 keer zo lang als die van woensdag (1,27 kWh), terwijl het 1,9 keer zoveel is. Bij een lijngrafiek mag een as elders beginnen (je kijkt naar het verloop, niet naar de lengte), zolang de getallen op de as staan.
Twee y-assen. Met een tweede as kies je zelf hoe hoog en hoe steil een reeks lijkt. Hieronder lijken de temperatuur en de batterijspanning samen te bewegen, alsof warmte de batterij oplaadt. Maar beide volgen gewoon de zon: overdag laadt de batterij (spanning omhoog) en warmt de module op. Met een andere keuze van de rechteras lopen ze helemaal niet gelijk.
| truc | wat het doet | tegengif |
|---|---|---|
| afgeknotte as bij staven | kleine verschillen lijken groot | staven altijd vanaf 0 |
| twee y-assen | elke gewenste 'samenhang' is te maken door de assen te kiezen | twee grafieken onder elkaar, of één as |
| kersen plukken | alleen de periode tonen die het verhaal steunt | de hele reeks, of zeggen waarom een stuk |
| oppervlakte of volume als pictogram | een verdubbeling lijkt een verviervoudiging | lengte evenredig met de waarde (staaf) |
| gaten verbinden | een lijn over ontbrekende metingen verzint data | de lijn onderbreken |
| geen eenheid, geen bron | niemand kan nagaan wat er getoond wordt | grootheid, eenheid, bron en periode |
Misleidende grafieken: kersen plukken, pictogrammen en gaten
Kersen plukken. Wie alleen donderdag toont, kan schrijven dat 'de zon 67 % meer levert dan de module verbruikt'; wie alleen woensdag toont, dat 'de module 0,88 kWh per dag tekortkomt'. Beide zijn waar voor die dag, en beide misleiden. Over de hele week leverde de zon 12,4 kWh en verbruikte de module 12,0 kWh.
Oppervlakte en volume. Een pictogram (een zon, een batterij, een zak) dat in hoogte én breedte meegroeit, groeit in oppervlakte met het kwadraat. De statisticus Edward Tufte noemde de verhouding tussen het effect in de grafiek en het effect in de data de liegfactor; eerlijk is 1.
Gaten verbinden. Woensdag van 11:47 tot 11:58 ontbreken metingen (hoofdstuk 30). Een lijn die de punten ervoor en erna verbindt, verzint een verloop. matplotlib onderbreekt de lijn als je op die plaats een lege waarde (float('nan')) in de lijst zet.
De liegfactor van het zonnepictogram
Bereken de liegfactor van het pictogram hierboven: woensdag 1,27 kWh, donderdag 2,43 kWh, en de diameter van de zon is evenredig met de zonnestroom.
- woensdag , donderdag
- diameter evenredig met de waarde
- het effect in de data, het effect in de grafiek, de liegfactor
- 1In de data: : donderdag is 91 % meer.
- 2In de grafiek: de diameter wordt keer groter, de oppervlakte dus keer: het effect is .
- 3Liegfactor: .
Een eerlijke grafiek in matplotlib
matplotlib kiest zelf de assen, en dat is niet altijd eerlijk: bij staafdiagrammen begint de as bij 0, maar bij een lijngrafiek zoomt ze in op de data. Met set_ylim leg je de as zelf vast. Dit programma tekent de zonnestroom per dag twee keer naast elkaar: eerlijk en met een afgeknotte as, zodat je het verschil zelf ziet. plt.subplots(1, 2) maakt twee grafieken naast elkaar.
# eerlijke_grafiek.py - dezelfde zonnestroom per dag, eerlijk en misleidendimport matplotlib.pyplot as plt dagen = ["ma", "di", "wo", "do", "vr", "za", "zo"]zon = [1.74, 1.71, 1.27, 2.43, 1.69, 1.66, 1.89] # kWh per dag (week_uur.csv) figuur, (links, rechts) = plt.subplots(1, 2, figsize=(10, 4))links.bar(dagen, zon, color="tab:orange")links.set_ylim(0, 2.6) # eerlijk: de as begint bij 0links.set_ylabel("zonnestroom (kWh per dag)")links.set_title("eerlijk")rechts.bar(dagen, zon, color="tab:orange")rechts.set_ylim(1.2, 2.5) # misleidend: de as begint bij 1,2rechts.set_title("misleidend: afgeknotte as")for as_ in (links, rechts): as_.grid(axis="y")figuur.tight_layout()figuur.savefig("zon_per_dag.png", dpi=150)print("zon_per_dag.png bewaard")Uitvoer: zon_per_dag.png bewaard. De twee grafieken zien eruit zoals de staafdiagrammen op het blad over de as. Wie een grafiek in een verslag zet, kiest de as bewust en schrijft er het waarom bij.
Zet het programma dat een grafiek maakte bij je verslag. Dan kan iedereen nagaan welke data en welke keuzes erachter zitten, en de grafiek opnieuw maken als er nieuwe metingen zijn.
Correlatie is geen oorzakelijk verband
In hoofdstuk 28 berekende je de correlatiecoëfficiënt : als twee grootheden perfect samen stijgen, als de ene daalt wanneer de andere stijgt, 0 als er geen rechtlijnig verband is. In de testweek is overdag tussen temperatuur en verbruik: warmere uren, minder verbruik. Zet de verwarming dan hoger om stroom te sparen? Nee. Een correlatie kan vier oorzaken hebben:
- De ene veroorzaakt de andere: meer daglicht doet de lampen dimmen, dus minder verbruik ().
- Een gemeenschappelijke oorzaak: het daglicht warmt de module op én dimt de lampen. Temperatuur en verbruik bewegen samen omdat ze allebei aan de zon hangen.
- De omgekeerde richting: soms is het gevolg de oorzaak. Brandende lampen warmen de module een beetje op (hoofdstuk 30): meer verbruik, iets warmer.
- Toeval of selectie: met weinig metingen of een gekozen stuk van de data vind je altijd wel een verband. Over alle uren van de week, ook 's nachts, is : een ander stuk, een ander getal.
Een eenvoudige test voor een gemeenschappelijke oorzaak: houd ze constant. Kijk alleen naar uren met ongeveer hetzelfde daglicht. Verdwijnt het verband binnen elke groep, dan liep het via het licht. In de figuur zijn de uren gekleurd naar het daglicht: binnen een kleur is er nauwelijks een helling.
In 2000 toonde de statisticus Robert Matthews dat het aantal ooievaarsparen in Europese landen sterk samenhangt met het aantal geboorten (p = 0,008). Ooievaars brengen geen baby's: grote landen hebben meer van beide. Een oorzaak bewijs je met een proef waarin je één ding verandert en de rest gelijk houdt (hoofdstuk 2), of met een verklaring die alle alternatieven uitsluit, zoals Snow deed.
Het verband binnen groepen: correlatie.py
Het programma berekent voor alle uren overdag, en daarna opnieuw binnen drie groepen met ongeveer hetzelfde daglicht. De functie correlatie() is die van hoofdstuk 28.
# correlatie.py - hangt het verbruik af van de temperatuur? (overdag, 8 tot 17 uur)import csv def correlatie(x, y): """Correlatiecoëfficiënt r van Pearson (hoofdstuk 28).""" mx, my = sum(x) / len(x), sum(y) / len(y) sxy = sum((a - mx) * (b - my) for a, b in zip(x, y)) sxx = sum((a - mx) ** 2 for a in x) syy = sum((b - my) ** 2 for b in y) return sxy / (sxx * syy) ** 0.5 with open("week_uur.csv", newline="") as f: uren = [r for r in csv.DictReader(f) if 8 <= int(r["uur"][11:13]) <= 16]T = [float(r["temperatuur_C"]) for r in uren]V = [float(r["verbruik_Wh"]) for r in uren]L = [float(r["licht_lx"]) for r in uren]print(f"{len(uren)} uren overdag")print(f"temperatuur en verbruik: r = {correlatie(T, V):+.2f}")print(f"licht en verbruik: r = {correlatie(L, V):+.2f}")print(f"licht en temperatuur: r = {correlatie(L, T):+.2f}")for naam, laag, hoog in (("donker", 0, 5000), ("half", 5000, 15000), ("licht", 15000, 1e9)): groep = [i for i in range(len(uren)) if laag <= L[i] < hoog] r = correlatie([T[i] for i in groep], [V[i] for i in groep]) print(f" alleen {naam:6} ({len(groep):2d} uren): temperatuur en verbruik r = {r:+.2f}")Uitvoer:
63 uren overdag
temperatuur en verbruik: r = -0.40
licht en verbruik:       r = -0.75
licht en temperatuur:    r = +0.67
  alleen donker ( 8 uren): temperatuur en verbruik r = +0.28
  alleen half   (30 uren): temperatuur en verbruik r = -0.08
  alleen licht  (25 uren): temperatuur en verbruik r = +0.00
Samen , binnen de groepen tussen en : het verband tussen temperatuur en verbruik verdwijnt bijna als het licht gelijk blijft. De zon is de gemeenschappelijke oorzaak. Kijk ook naar de kolom zon_Wh: die meet de geleverde zonnestroom, die afgeknepen wordt als de batterij vol is (hoofdstuk 30). Daarom is haar correlatie met de temperatuur zelfs negatief (): wie zon_Wh als maat voor zonneschijn gebruikt, trekt de verkeerde conclusie. Weet wat een kolom meet.
Wat AI en machine learning zijn, en wat niet
Kunstmatige intelligentie (AI) is een verzamelnaam voor computersystemen die taken uitvoeren waarvoor mensen intelligentie gebruiken: herkennen, voorspellen, plannen, taal verwerken. Het grootste deel van de huidige AI is machine learning: de computer leert een regel uit voorbeelden, in plaats van dat een mens de regel programmeert.
In hoofdstuk 25 van Fundamental schreef je zelf: 'water geven onder 30 % bodemvocht'. Bij machine learning geef je de computer voorbeelden: kenmerken (temperatuur, vocht, licht) met het juiste label (slap of niet slap). Een leeralgoritme zoekt een regel die de labels zo goed mogelijk voorspelt: het model. Dat heet trainen. Daarna gebruik je het model op nieuwe gevallen.
| soort taak | wat het model leert | voorbeeld in Habitat | waar |
|---|---|---|---|
| classificeren | een categorie kiezen | slap of niet slap; zieke of gezonde plant | I39, E42 |
| regressie | een getal voorspellen | het verbruik van morgen | E41 |
| clusteren | groepen vinden zonder labels | soorten dagen in het logboek | E42 |
| neurale netwerken | ingewikkelde verbanden uit veel data | de zonne-opbrengst uit de weersvoorspelling | E43 |
| taal- en beeldmodellen | het volgende woord of beeldstukje voorspellen | een assistent die het logboek samenvat | E44 |
Wat AI niet is: een model begrijpt niets. Het vindt patronen in de voorbeelden die het kreeg, en meer niet. Het weet niet waarom sla slap hangt, het kent geen natuurkunde, en het kan niet weten wat het nooit zag. Ook een taalmodel dat vlot praat, voorspelt woord na woord wat waarschijnlijk volgt (Expert, hoofdstuk 44). 'Intelligent' zegt iets over de taak, niet over begrip.
De beslisboom
Een beslisboom voorspelt met een reeks ja/nee-vragen. Je begint bovenaan (de wortel) en volgt bij elke vraag de tak die past, tot je in een blad komt: daar staat de voorspelling. Hij lijkt op het stroomdiagram van hoofdstuk 22 en op een rij if-vragen in Python of C++ (hoofdstuk 27 en 32). Het verschil: de vragen en de grenzen zijn niet door een mens gekozen, maar geleerd uit data.
De boom hieronder werd getraind op de inspecties van juni en juli. Hij stelt twee vragen. Is er weinig daglicht (hoogstens 29,5 klx), dan verdampt de sla weinig: niet slap. Is er veel licht, dan hangt het af van de lucht: droge lucht (vocht hoogstens 60,5 %) trekt water uit de bladeren, en dan verwacht de boom slappe sla.
Hoe vindt de computer de vragen? Hij probeert elke mogelijke vraag: elk kenmerk, en elke grens tussen twee gemeten waarden. Voor elke vraag splitst hij de voorbeelden in een ja- en een nee-groep, en meet hoe zuiver die groepen zijn: hoe goed ze bestaan uit één soort label. De beste vraag komt bovenaan. Daarna doet hij hetzelfde in elke groep, tot een gekozen diepte.
Met de hand tel je fouten: dat is eenvoudig en meestal goed genoeg. Maar fouten tellen ziet soms geen verschil tussen twee splitsingen waarvan de ene veel nuttiger is. Voorbeeld: 400 slap en 400 niet slap. Splitsing A geeft groepen (300 slap, 100 niet) en (100, 300): 200 fouten. Splitsing B geeft (200, 400) en (200, 0): ook 200 fouten, maar B maakt een groep die al helemaal zuiver is. De onzuiverheid ziet dat: A 0,375, B 0,333. De computer kiest B.
Een beslisboom met de hand
Zestien inspecties van 10 tot 16 juni (tabel). Zoek de beste eerste vraag voor een boom, op daglicht of op temperatuur, door fouten te tellen. Toets de regel daarna op de zestien inspecties die volgen.
| tijdstip | T (°C) | vocht (%) | licht (klx) | slap |
|---|---|---|---|---|
| 10/6 14:00 | 28,0 | 52 | 49 | ja |
| 10/6 17:00 | 27,1 | 58 | 35 | ja |
| 11/6 11:00 | 24,0 | 71 | 26 | nee |
| 11/6 14:00 | 24,2 | 61 | 27 | nee |
| 11/6 17:00 | 23,9 | 68 | 16 | nee |
| 12/6 11:00 | 25,0 | 64 | 36 | ja |
| 12/6 14:00 | 26,1 | 60 | 37 | ja |
| 12/6 17:00 | 26,4 | 60 | 19 | nee |
| 13/6 11:00 | 27,7 | 57 | 33 | ja |
| 14/6 11:00 | 22,4 | 74 | 14 | nee |
| 14/6 17:00 | 21,8 | 68 | 11 | nee |
| 15/6 11:00 | 26,6 | 66 | 29 | nee |
| 15/6 14:00 | 28,2 | 47 | 31 | ja |
| 15/6 17:00 | 24,5 | 64 | 23 | nee |
| 16/6 11:00 | 23,3 | 73 | 18 | nee |
| 16/6 14:00 | 23,3 | 75 | 15 | ja |
- 16 inspecties met temperatuur, vocht, daglicht en het label
- een splitsing voorspelt in elke groep het label dat het meest voorkomt
- de beste grens voor daglicht en voor temperatuur, met het aantal fouten
- de juistheid op de volgende 16
- 1Sorteer op daglicht en probeer elke grens midden tussen twee waarden. Voorbeeld: grens 30 klx. Links (licht ≤ 30) liggen 10 inspecties, waarvan 1 slap: voorspel 'niet slap', 1 fout. Rechts 6, alle 6 slap: 0 fouten. Samen 1 fout. De andere grenzen:
grens licht (klx) fouten links + rechts 12,5 0 + 7 = 7 14,5 0 + 7 = 7 15,5 1 + 6 = 7 17,0 1 + 6 = 7 18,5 1 + 5 = 6 21,0 1 + 4 = 5 24,5 1 + 3 = 4 26,5 1 + 2 = 3 28,0 1 + 1 = 2 30,0 1 + 0 = 1 32,0 2 + 0 = 2 34,0 3 + 0 = 3 35,5 4 + 0 = 4 36,5 5 + 0 = 5 43,0 6 + 0 = 6 - 2Sorteer op temperatuur en doe hetzelfde. De beste grens is 24,75 °C met 3 fouten: links 8 inspecties waarvan 1 slap, rechts 8 waarvan 6 slap.
- 3Kies de vraag met de minste fouten: 'daglicht > 30 klx? dan slap'. De ene fout (16 juni om 14 uur: 23,3 °C, 75 %, 15 klx, toch slap genoteerd) kan geen enkele regel vermijden: misschien is het een vergissing bij het noteren.
- 4Toetsen op de 16 inspecties van 16 tot 23 juni: de regel voorspelt er 13 juist, 81 %. Op de voorbeelden waaruit hij geleerd werd, was het 94 % (15 van 16).
De data: een zomer inspecties
Om een model te trainen, heb je voorbeelden met labels nodig. In de zomer van 2026 keek een bewoner van het station om 11, 14 en 17 uur naar de sla in de oudste goot en noteerde of de bladeren slap hingen; de logger gaf de temperatuur, de luchtvochtigheid en het daglicht op dat moment. Dit boek kan geen echte zomer meten, dus maakt het programma hieronder testdata met een model (zoals in hoofdstuk 30): de sla hangt slap als ze harder verdampt dan de wortels water kunnen opnemen. Hoe hard ze verdampt, hangt af van het dampdruktekort (hoe droog de lucht is voor die temperatuur) en van het licht.
# maak_slapdata.py - een zomer inspecties van de sla in de klimaatmodule (een model, geen echte metingen)import mathimport random rng = random.Random(1) # vast zaadje: iedereen krijgt dezelfde data def dampdruk(t): """Verzadigde dampdruk van water (kPa) bij t graden Celsius (formule van Tetens).""" return 0.6108 * math.exp(17.27 * t / (t + 237.3)) regels = ["tijdstip,temperatuur_C,vocht_pct,licht_klx,bewoner,slap"]for dag in range(92): # 1 juni tot en met 31 augustus 2026 maand, nr = (6, dag + 1) if dag < 30 else (7, dag - 29) if dag < 61 else (8, dag - 60) w = min(1.0, max(0.0, rng.gauss(0.55, 0.3))) # hoe helder de dag is (0 tot 1) t_buiten = 17 + 11 * w + rng.gauss(0, 2) + (2 if 30 <= dag < 75 else 0) bewoner = "A" if (dag // 7) % 2 == 0 else "B" # om de week kijkt een andere bewoner for uur in (11, 14, 17): if dag % 7 in (5, 6) and rng.random() < 0.7: continue # in het weekend meestal niemand zon = max(0.0, math.sin(math.pi * (uur - 5.5) / 15.0)) * w t = 18 + (t_buiten - 17) * 0.6 + 4 * zon + rng.gauss(0, 1.0) rv = min(95.0, max(30.0, 82 - 1.8 * (t - 18) - 12 * zon + rng.gauss(0, 5))) licht = max(0.0, 55 * zon + rng.gauss(0, 3)) # daglicht op de lichtsensor (klx) vraag = dampdruk(t) * (1 - rv / 100) * (licht + 15) / 45 # hoe hard de plant verdampt (model) slap = vraag > (1.6 if bewoner == "A" else 1.25) # B noemt de sla sneller slap if rng.random() < 0.05: slap = not slap # een vergissing bij het noteren regels.append(f"2026-{maand:02d}-{nr:02d} {uur}:00,{t:.1f},{rv:.0f},{licht:.0f},{bewoner},{int(slap)}")with open("slap.csv", "w", newline="") as f: f.write("\n".join(regels) + "\n")print(len(regels) - 1, "inspecties in slap.csv")Uitvoer, en het begin van slap.csv:
228 inspecties in slap.csv
tijdstip,temperatuur_C,vocht_pct,licht_klx,bewoner,slap
2026-06-01 11:00,29.4,47,44,A,1
2026-06-01 14:00,29.6,51,49,A,0
2026-06-01 17:00,29.0,50,34,A,1
…
228 inspecties, waarvan 30 % slap. Drie dingen in dit model komen terug: om de week kijkt een andere bewoner, en bewoner B noemt de sla sneller slap dan A; in het weekend is er meestal niemand; en 5 % van de labels is een vergissing. Echte data hebben zulke eigenaardigheden altijd. Het model weet daar niets van: het krijgt alleen de kolommen.
beslisboom.py: trainen en toetsen
De boom van nul af, in een zeventigtal regels. beste_splitsing() probeert elke vraag en houdt de zuiverste. bouw() splitst en roept zichzelf op voor elke helft (een functie die zichzelf oproept, heet recursief: Expert, hoofdstuk 34), tot de diepte op is of een splitsing niet meer helpt. Een vraag met twee gelijke antwoorden wordt geschrapt. De boom is een woordenboek in een woordenboek. Getraind wordt op juni en juli, getoetst op augustus: data die het model nooit zag, en die na de trainingsdata komen, zoals in het echt.
# beslisboom.py - een beslisboom van nul af, getraind op juni en juli, getoetst op augustusimport csv KENMERKEN = ["temperatuur_C", "vocht_pct", "licht_klx"] def lees(naam): with open(naam, newline="") as f: return [{"x": [float(r[k]) for k in KENMERKEN], "y": int(r["slap"]), "tijd": r["tijdstip"]} for r in csv.DictReader(f)] def onzuiverheid(rijen): """2 p (1 - p), met p het deel 'slap': 0 als alle labels gelijk zijn, 0,5 bij half om half.""" p = sum(r["y"] for r in rijen) / len(rijen) return 2 * p * (1 - p) def beste_splitsing(rijen, min_blad): """(onzuiverheid, kenmerk, grens) van de beste vraag 'kenmerk <= grens?', of None als er geen is.""" beste = None for k in range(len(KENMERKEN)): waarden = sorted(set(r["x"][k] for r in rijen)) for a, b in zip(waarden, waarden[1:]): grens = (a + b) / 2 # midden tussen twee gemeten waarden ja = [r for r in rijen if r["x"][k] <= grens] nee = [r for r in rijen if r["x"][k] > grens] if len(ja) < min_blad or len(nee) < min_blad: continue o = (len(ja) * onzuiverheid(ja) + len(nee) * onzuiverheid(nee)) / len(rijen) if beste is None or o < beste[0]: beste = (o, k, grens) return beste def bouw(rijen, diepte, min_blad=5): """Een boom als woordenboek: een blad {'label', 'n'} of een vraag met een ja- en een nee-tak.""" s = beste_splitsing(rijen, min_blad) if diepte == 0 or s is None or s[0] >= onzuiverheid(rijen): ja = sum(r["y"] for r in rijen) return {"label": int(ja > len(rijen) - ja), "n": len(rijen)} _, k, grens = s ja = bouw([r for r in rijen if r["x"][k] <= grens], diepte - 1, min_blad) # de functie roept zichzelf op nee = bouw([r for r in rijen if r["x"][k] > grens], diepte - 1, min_blad) if "label" in ja and "label" in nee and ja["label"] == nee["label"]: return {"label": ja["label"], "n": len(rijen)} # twee gelijke bladen: de vraag is overbodig return {"kenmerk": k, "grens": grens, "ja": ja, "nee": nee} def voorspel(boom, x): while "label" not in boom: boom = boom["ja"] if x[boom["kenmerk"]] <= boom["grens"] else boom["nee"] return boom["label"] def toon(boom, inspring=""): if "label" in boom: print(inspring + ("slap" if boom["label"] else "niet slap"), f"({boom['n']} inspecties)") else: print(inspring + f"{KENMERKEN[boom['kenmerk']]} <= {boom['grens']:.1f}?") toon(boom["ja"], inspring + " ja: ") toon(boom["nee"], inspring + " nee: ") def juist(boom, rijen): return sum(voorspel(boom, r["x"]) == r["y"] for r in rijen) / len(rijen) rijen = lees("slap.csv")train = [r for r in rijen if r["tijd"] < "2026-08"] # juni en juli: lerentest = [r for r in rijen if r["tijd"] >= "2026-08"] # augustus: toetsenif __name__ == "__main__": boom = bouw(train, diepte=2) toon(boom) print(f"train: {len(train)} inspecties, {juist(boom, train):.0%} juist") print(f"test: {len(test)} inspecties, {juist(boom, test):.0%} juist")Uitvoer:
licht_klx <= 29.5?
  ja:  niet slap (103 inspecties)
  nee: vocht_pct <= 60.5?
  nee:   ja:  slap (37 inspecties)
  nee:   nee: niet slap (14 inspecties)
train: 154 inspecties, 90% juist
test:  74 inspecties, 82% juist
Op de trainingsdata 90 % juist, op augustus 82 %. Dat verschil is normaal: het model leerde ook een stukje van de toevalligheden van juni en juli. Professionele bibliotheken zoals scikit-learn doen hetzelfde, sneller en met meer opties; wie de boom zelf schreef, weet wat er in die bibliotheek gebeurt.
Trainen en testen: hoe goed is het model?
Een model beoordeel je altijd op data die het niet zag: de testdata. Splits bij metingen in de tijd op een datum (leren op het verleden, toetsen op de toekomst), niet willekeurig: anders test je met uren die vlak naast een trainingsuur liggen en bijna hetzelfde zijn.
De juistheid (het deel juiste voorspellingen) zegt niet alles. In augustus hing de sla bij 53 van de 74 inspecties niet slap: een 'model' dat altijd 'niet slap' zegt, is al 72 % juist. Dat is de basislijn. De boom haalt 82 %: beter, maar minder indrukwekkend dan het getal alleen doet denken.
Kijk daarom naar de soorten fouten, in een verwarringsmatrix. De boom miste 8 keer slappe sla (gemist) en voorspelde 5 keer slap terwijl het niet zo was (vals alarm). Welke fout erger is, hangt af van wat je met de voorspelling doet. Voor een extra pompbeurt is een vals alarm goedkoop (5 minuten pompen is 1 Wh), een gemiste slappe sla niet.
Hoe diep mag de boom?
Een diepere boom stelt meer vragen en past de trainingsdata beter. Is dat ook beter voor augustus? Train bomen van diepte 0 tot 8, waarbij een blad mag bestaan uit één inspectie, en vergelijk.
- beslisboom.py als module
- min_blad = 1
- de juistheid op train en test per diepte, en de beste diepte
- 1Programma, dat de functies uit beslisboom.py importeert:
# diepte.py - hoe diep mag de boom? (min_blad = 1: de boom mag tot op één inspectie splitsen)
from beslisboom import bouw, juist, train, test

print("diepte  train   test")
for diepte in range(0, 9):
    boom = bouw(train, diepte, min_blad=1)
    print(f"{diepte:5d}   {juist(boom, train):4.0%}   {juist(boom, test):4.0%}")
diepte train test 0 69% 72% 1 90% 77% 2 91% 82% 3 94% 77% 4 95% 81% 5 97% 78% 6 98% 78% 7 99% 78% 8 99% 76% - 2Train stijgt tot bijna 100 %: een diepe boom stelt zoveel vragen dat hij bijna elke trainingsinspectie apart kan zetten, ook de 5 % vergissingen.
- 3Test is het best bij diepte 2 (82 %) en blijft daarna lager, met wat geschommel: de extra vragen leerden de toevalligheden van juni en juli, niet de sla. Dat heet overfitting.
Bias in data
Een model leert uit de voorbeelden die het krijgt, met al hun scheefheden. Dat heet bias in data. In de inspecties van de zomer zitten er drie:
- Wie labelt. Bewoner A noteerde in 25 % van de inspecties 'slap', bewoner B in 36 %. Was het warmer in de weken van B? Vergelijk bij hetzelfde daglicht (figuur): tussen 30 en 40 klx noteerde A 50 % slap, B 77 %. B noemt de sla sneller slap. Het model leert een gemiddelde van twee meningen, en wordt strenger als er meer weken van B in de data zitten.
- Wanneer gemeten. Alleen om 11, 14 en 17 uur, vooral op weekdagen. Over de ochtend, de avond en de nacht weet het model niets. Gebruik je het om 7 uur, dan voorspelt het iets over een situatie die het nooit zag.
- Welke periode. Alleen de zomer, met één soort sla in de oudste goot. In oktober, met jonge plantjes of een ander ras, kan het verband anders zijn.
Wat helpt: vooraf afspreken wat 'slap' is (een foto met een voorbeeld, of de hoek van een blad meten), labels blind laten controleren door een tweede persoon, meten op alle uren en alle dagen, en noteren wie, wanneer en hoe gemeten werd, zodat je bias kan opsporen.
In de jaren 1990 trainden onderzoekers een model dat voorspelde welke patiënten met een longontsteking een hoog risico liepen om te overlijden. Het model leerde iets vreemds: astma verlaagde het risico. De data klopten: astmapatiënten met een longontsteking gingen meteen naar intensieve zorg, en overleefden daardoor vaker. Het model zag de behandeling niet, alleen de uitkomst. Had men het gebruikt om patiënten naar huis te sturen, dan waren juist de kwetsbaarste naar huis gegaan. Omdat het model leesbare regels had (zoals een beslisboom), zag men de fout. R. Caruana en collega's beschreven het geval in 2015.
Een beslisboom voor het klaslokaal
Kan een beslisboom uit de metingen van een datalogger voorspellen of er een raam openstaat?
- de datalogger van hoofdstuk 30 (SHT31, klok, SD-kaart), op een kast in het lokaal
- een blad om bij te houden wanneer een raam open en dicht gaat
- Python met beslisboom.py
- 1Laat de logger twee schooldagen lang elke minuut meten. Noteer op het blad elk tijdstip waarop een raam open- of dichtgaat: dat zijn de labels.
- 2Maak in Python per minuut twee kenmerken: de verandering van de temperatuur over de laatste 5 minuten, en die van de luchtvochtigheid. Voeg het label toe (1 = een raam staat open).
- 3Train een boom van diepte 1 en 2 op de eerste dag (pas KENMERKEN in beslisboom.py aan), en toets op de tweede dag.
- 4Maak een verwarringsmatrix. Wanneer vergist de boom zich?
Typisch: de eerste vraag gaat over de temperatuurverandering (bv. 'daalt de temperatuur meer dan 0,3 °C in 5 minuten?'). De boom vindt een open raam in de winter vaak, maar mist het in warm weer (buiten even warm als binnen) en geeft vals alarm als de klas vertrekt of de verwarming uitvalt.
Een open raam laat in de winter koude, droge lucht binnen: temperatuur en vochtigheid dalen snel. De boom leert die 'handtekening'. Hij leert niet wat een raam is: als het buiten even warm is, is er geen handtekening, en een andere oorzaak van afkoeling (een lege klas) lijkt voor hem op een open raam. Een model is zo goed als de kenmerken die je het geeft, en de periode waarin je leerde.
Van boom naar klimaat.ino
Een getrainde beslisboom is na het trainen gewoon een paar if-vragen. Die passen in de Arduino Mega van de klimaatmodule, zonder bibliotheek en zonder internet. De functie hieronder is de boom van dit hoofdstuk in C++. Getest met g++ op de 74 inspecties van augustus (het testprogramma zit bij de bijlagen): dezelfde uitkomst als in Python.
// slap.h - de beslisboom van hoofdstuk 39, getraind op de inspecties van juni en juli 2026.// licht_klx: daglicht op de lichtsensor (klx); vocht_pct: relatieve vochtigheid van de lucht (SHT31).bool slapVerwacht(float licht_klx, float vocht_pct) { if (licht_klx <= 29.5) { return false; // weinig licht: de sla verdampt weinig } if (vocht_pct <= 60.5) { return true; // veel licht en droge lucht: slap verwacht } return false; // veel licht, maar vochtige lucht}Uitvoer van slap_test.cpp:
2026-08-02 11:00  licht   47 klx  vocht  44 %  voorspeld slap      genoteerd slap
2026-08-02 14:00  licht   51 klx  vocht  61 %  voorspeld niet slap genoteerd slap
2026-08-02 17:00  licht   33 klx  vocht  50 %  voorspeld slap      genoteerd slap
2026-08-03 11:00  licht   15 klx  vocht  61 %  voorspeld niet slap genoteerd niet slap
2026-08-03 14:00  licht   13 klx  vocht  75 %  voorspeld niet slap genoteerd niet slap
2026-08-03 17:00  licht   13 klx  vocht  79 %  voorspeld niet slap genoteerd niet slap
augustus: 61 van 74 juist
In klimaat.ino wordt het een taak (hoofdstuk 29): om het halve uur kijkt ze of er slappe sla verwacht wordt, en laat dan de pomp 5 minuten extra draaien. De lichtgrens is bewust lager gezet dan in de boom (25 in plaats van 29,5 klx): liever een vals alarm (1 Wh) dan een gemiste slappe sla.
// in klimaat.ino (versie 4, hoofdstuk 32; in versie 5 van hoofdstuk 40 stuurt één taak de pomp): om het halve uur een extra pompbeurt van 5 minuten als de sla slap dreigt te worden
const float LICHT_GRENS = 25.0;          // klx: lager dan de 29,5 van de boom, liever vals alarm dan gemist
const float VOCHT_GRENS = 60.5;          // % relatieve vochtigheid: de tweede vraag van de boom
unsigned long extraPompTot = 0;          // millis() waarop de extra pompbeurt stopt (0 = geen)

bool slapMetMarge(float licht_klx, float vocht_pct) {
  return licht_klx > LICHT_GRENS && vocht_pct <= VOCHT_GRENS;
}

void taakExtraPomp(int minuut, float lichtLux, float vocht) {      // om de 2 s opgeroepen, zoals de meettaak
  if (minuut == 30 && extraPompTot == 0 && slapMetMarge(lichtLux / 1000.0, vocht)) {
    extraPompTot = millis() + 5UL * 60UL * 1000UL;
    Serial.println(F("# extra pompbeurt: slappe sla verwacht"));
  }
  if (extraPompTot != 0) {
    digitalWrite(POMP, (long)(millis() - extraPompTot) < 0 ? HIGH : LOW);
    if ((long)(millis() - extraPompTot) >= 0) extraPompTot = 0;
  }
}
De extra pompbeurt is een aanvulling op de pomp van minuut 0 tot 9, niet een vervanging. De beveiligingen (vlotter tegen droogdraaien, alarm bij een laag reservoir, hoofdstuk 32) blijven gewone regels die altijd voorgaan. Een geleerd model mag adviseren; een veiligheidsregel beslist.
Wat een model niet kan, en wie beslist
De boom van dit hoofdstuk voorspelt slappe sla in ongeveer vier van de vijf gevallen. Daar houdt het op. Wat hij niet kan:
- Iets herkennen wat hij nooit zag. Valt de pomp uit, dan hangt alle sla slap, ook bij weinig licht. De boom zegt 'niet slap': in de data was er nooit een pompstoring. Daarvoor dienen sensoren en gewone regels.
- Uitleggen waarom. Hij weet dat veel licht en droge lucht samengaan met slappe sla, niet dat de bladeren water verliezen. Dat de regel natuurkundig klopt (dampdruktekort), is geluk en goede kenmerken.
- Beter zijn dan zijn labels. Als bewoners zich vergissen of anders oordelen, leert de boom dat mee.
- Zeker zijn. Elke voorspelling is een gok met een foutkans; die moet je kennen en aanvaarden.
Wie laat een model beslissen, en over wat? Een extra pompbeurt is goedkoop en onschuldig: die mag de module zelf nemen. Een beslissing over mensen (wie mag binnen, wie krijgt zorg) is iets anders. Stel bij elk model vier vragen: Wat gebeurt er bij een fout, en voor wie? Kan een mens de beslissing zien, begrijpen en terugdraaien? Op welke data is het getraind, en past dat bij waar het gebruikt wordt? Wie is verantwoordelijk? De Europese AI-verordening (in werking sinds 1 augustus 2024) legt strengere regels op naarmate een AI-systeem meer risico inhoudt voor mensen. In Expert (hoofdstuk 44) maak je er een afwegingskader van voor het brein van het station.
Grafieken, correlatie en beslisbomen
| symbool | betekenis | eenheid |
|---|---|---|
| van −1 tot +1 | – |
| symbool | betekenis | eenheid |
|---|---|---|
| deel met label 'slap' | – |
| vraag | grafiek | voorbeeld uit de module |
|---|---|---|
| hoe verandert iets in de tijd? | lijngrafiek | temperatuur per uur |
| hoe verhouden aparte groepen zich? | staafdiagram | verbruik en zon per dag |
| hangen twee grootheden samen? | spreidingsdiagram | verbruik tegenover daglicht |
| hoe zijn metingen verdeeld? | histogram | hoe vaak elke temperatuur voorkwam |
| welk deel van een geheel? | taartdiagram (weinig delen) of gestapelde staaf | het energiebudget: 93 % lampen |
| truc | wat het doet | tegengif |
|---|---|---|
| afgeknotte as bij staven | kleine verschillen lijken groot | staven altijd vanaf 0 |
| twee y-assen | elke gewenste 'samenhang' is te maken door de assen te kiezen | twee grafieken onder elkaar, of één as |
| kersen plukken | alleen de periode tonen die het verhaal steunt | de hele reeks, of zeggen waarom een stuk |
| oppervlakte of volume als pictogram | een verdubbeling lijkt een verviervoudiging | lengte evenredig met de waarde (staaf) |
| gaten verbinden | een lijn over ontbrekende metingen verzint data | de lijn onderbreken |
| geen eenheid, geen bron | niemand kan nagaan wat er getoond wordt | grootheid, eenheid, bron en periode |
| begrip | in dit hoofdstuk |
|---|---|
| kenmerken | temperatuur_C, vocht_pct, licht_klx |
| label | slap (1) of niet slap (0) |
| trainingsdata | juni en juli 2026 (154 inspecties) |
| testdata | augustus 2026 (74 inspecties) |
| model | beslisboom van diepte 2 |
| basislijn | altijd 'niet slap': 72 % juist in augustus |
| gemist / vals alarm | slap maar niet voorspeld / voorspeld maar niet slap |
| overfitting | train veel beter dan test; een diepere boom helpt dan niet |
Waar data en AI vandaan komen en naartoe gaan
Dit hoofdstuk sluit de leerlijn data en AI van Intermediate af. Grafieken en correlatie bouwen op Fundamental en op hoofdstuk 3 en 28; de logger en de CSV komen uit hoofdstuk 30; de beslisboom is een programma (P) dat uit metingen (O) leert. In Expert wordt het wiskundiger: regressie en kleinste kwadraten, classificatie met meer kenmerken, neurale netwerken, en een afwegingskader voor AI.
Tabel, grafiek, schaal en de keuze van het grafiektype.
De eerste kennismaking met systemen die leren uit voorbeelden.
Een oorzaak bewijs je met een eerlijke proef, niet met een correlatie.
Trendlijnen en de richtingscoëfficiënt: verbanden in data.
CSV, woordenboeken, matplotlib en de correlatiecoëfficiënt.
De logger, logboek.py en de testweek die hier per uur samengevat wordt.
Veilige toestanden en alarmen: regels die voorgaan op een geleerd model.
Data-analyse in Python en de extra pompbeurt in het technisch rapport van de module.
Hoe zeker is 82 %? Betrouwbaarheidsintervallen en toetsen.
Een getal voorspellen (het verbruik van morgen), overfitting en kruisvalidatie.
Beslisbomen, k-dichtstbijzijnde buren, precisie en recall, onevenwichtige data.
Modellen die ingewikkeldere verbanden leren, en waarom ze moeilijker uit te leggen zijn.
Bias, uitlegbaarheid, privacy en de Europese AI-verordening: mag het station zelf beslissen?
In het kort
- Kies de grafiek bij de vraag: lijn voor de tijd, staven voor groepen (vanaf 0), punten voor een verband, een histogram voor een verdeling.
- Misleiding zit vaak in de keuze: een afgeknotte as, twee assen, een gekozen periode, een pictogram dat in oppervlakte groeit (liegfactor), een lijn over een gat.
- Correlatie is geen oorzaak: zoek een gemeenschappelijke oorzaak door haar constant te houden, en denk aan de omgekeerde richting en aan toeval.
- Machine learning leert een regel (een model) uit voorbeelden met kenmerken en labels; het begrijpt niets en kent alleen wat in de data zat.
- Een beslisboom stelt ja/nee-vragen; de computer kiest telkens de vraag die de zuiverste groepen geeft (onzuiverheid ).
- Toets op data die het model niet zag, vergelijk met de basislijn en kijk naar de soorten fouten; een te diepe boom overfit.
- Bias in data (wie labelt, wanneer, welke periode) neemt het model over. Een model mag adviseren; veiligheidsregels beslissen.
Wat je nu kent
- spreidingsdiagram
- Grafiek met een punt per meting, met twee grootheden op de assen; toont of ze samenhangen.
- histogram
- Staafdiagram van hoe vaak metingen in elke klasse (bv. elke graad) vallen: de verdeling.
- liegfactor
- De grootte van een effect in de grafiek gedeeld door de grootte van het effect in de data (Tufte); eerlijk is 1.
- gemeenschappelijke oorzaak
- Een derde grootheid die twee andere tegelijk beïnvloedt, zodat die samen bewegen zonder elkaar te veroorzaken.
- machine learning
- Een computer leert regels uit voorbeelden (gegevens met de juiste antwoorden) in plaats van dat een mens ze programmeert.
- kenmerk
- Een gemeten grootheid die het model als invoer gebruikt, bv. temperatuur, vocht of daglicht.
- label
- Het juiste antwoord bij een voorbeeld, bv. 'slap' of 'niet slap'.
- beslisboom
- Model dat een voorspelling maakt met een reeks ja/nee-vragen over de kenmerken; de vragen en grenzen worden geleerd uit data.
- onzuiverheid
- Maat voor hoe gemengd de labels in een groep zijn: , 0 als alles gelijk is, 0,5 bij half om half.
- verwarringsmatrix
- Tabel die telt hoe vaak een model juist en fout voorspelt, per soort fout (gemist, vals alarm).
- overfitting
- Een model dat de trainingsdata (met hun toevallige ruis) uit het hoofd leert en daardoor slechter voorspelt op nieuwe data.
- bias in data
- Een scheefheid in de gegevens (wie ze verzamelde, wanneer, hoe gelabeld) die het model overneemt.